Usine logicielle IA : quoi vérifier avant la fusion du code
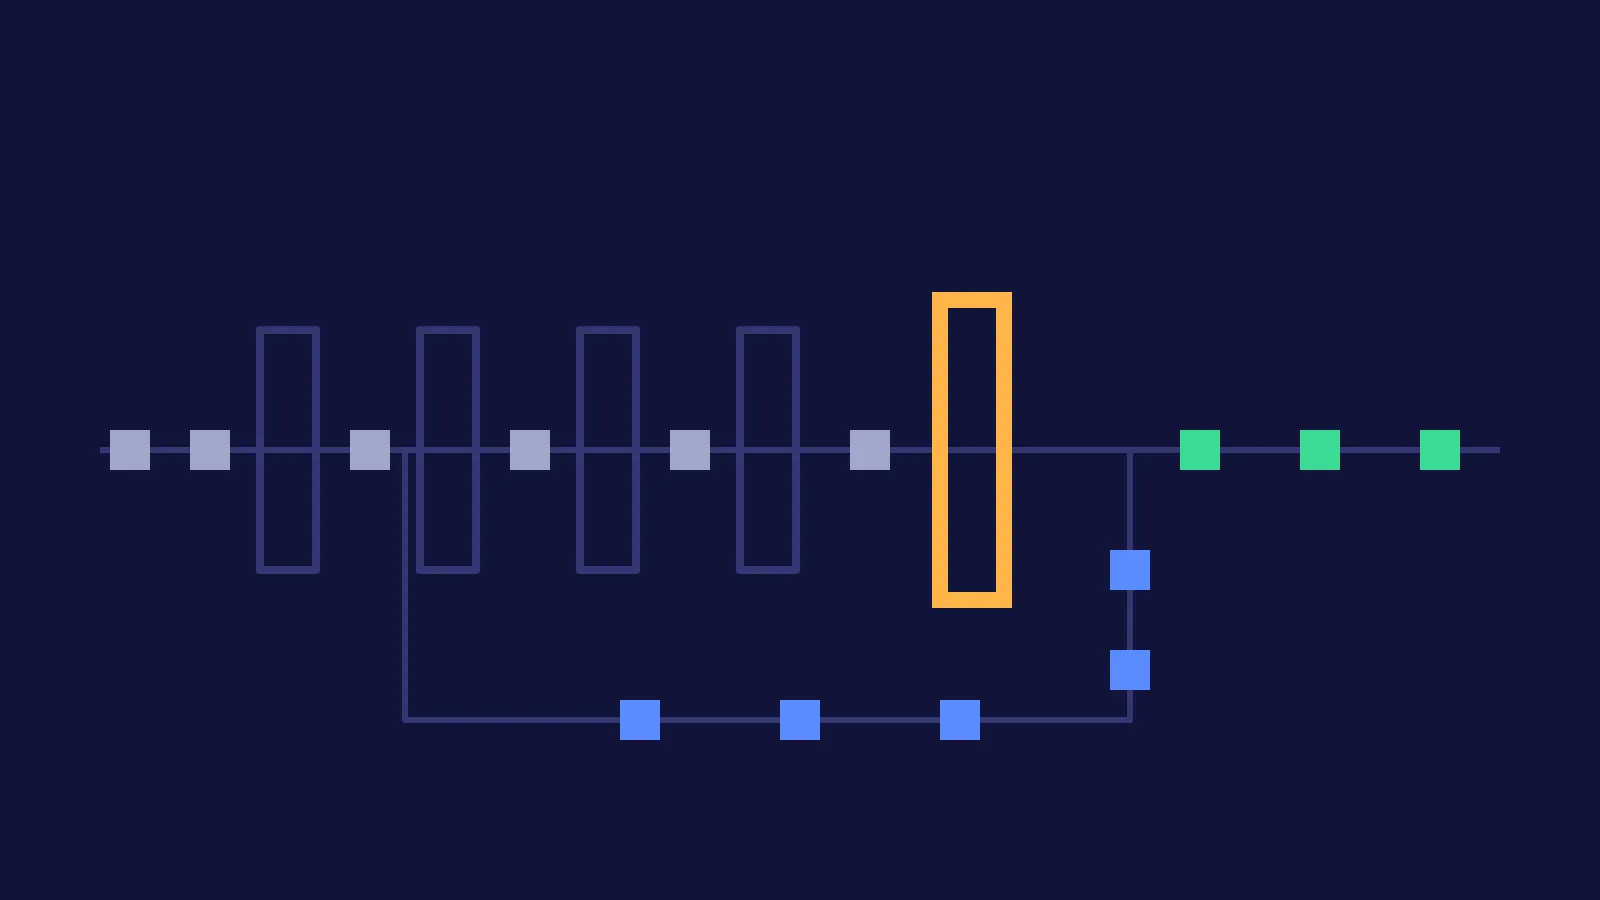
Une usine logicielle IA est une façon de développer où des agents de codage prennent une version planifiée, la découpent en billets, puis écrivent, testent et fusionnent le code de chaque billet avec peu ou pas de saisie humaine. Cet article examine ce qui doit être vrai d’un dépôt avant qu’une telle usine fusionne seule : ce que vérifient les grilles de préparation, ce qu’un pipeline de CI au vert ne prouve pas, et où les approbations humaines restent nécessaires. Il s’appuie sur des recherches publiées sur les agents qui trichent avec les tests, sur les contrôles que GitHub a mis autour de son propre agent de codage, et sur les fournisseurs qui vendent maintenant l’usine comme un produit.
L’expression existait à peine au début de 2026. En octobre, Port, une entreprise connue pour son portail interne de développeurs, l’avait mise dans le titre de sa page d’accueil (« AI Software Factory », consultée le 2026-10-26). Dans une vidéo réalisée en partenariat avec Port, publiée le 2026-10-23, le développeur Cole Medin présente sa propre usine et la couche que Port ajoute autour. Sa démonstration fait une bonne étude de cas, autant pour ce qu’elle montre que pour ce qu’une démonstration commanditée n’a aucune raison de montrer.
L’usine logicielle IA est un terme de janvier 2026
Le terme vient d’une échelle d’autonomie. Le 2026-01-23, Dan Shapiro a publié The Five Levels: from Spicy Autocomplete to the Dark Factory, calquée sur les niveaux d’automatisation de la conduite. Au niveau 3, le développeur passe ses journées à lire des diffs. Au niveau 4, il écrit des spécifications et revient des heures plus tard voir si les tests passent. Le niveau 5 est l’usine sombre (« dark factory »), nommée d’après l’usine de Fanuc exploitée par des robots, où personne n’a besoin d’être sur le plancher : les spécifications entrent, le logiciel sort, et personne ne regarde à l’intérieur. Selon Shapiro, presque tout le monde plafonne au niveau 3.
Deux semaines plus tard, StrongDM décrivait une équipe qui travaille au niveau 5. Dans Software Factories and the Agentic Moment, daté du 2026-02-06, le directeur technique Justin McCarthy pose deux règles pour l’équipe IA qu’il a fondée le 2025-07-14 :
« Le code ne doit pas être écrit par des humains. Le code ne doit pas être révisé par des humains. » - Justin McCarthy, StrongDM
L’équipe remplace la révision par des scénarios de bout en bout, exécutés contre des clones du comportement des services dont son produit dépend (Okta, Jira, Slack et plusieurs applications Google), et notés selon la part des exécutions susceptibles de satisfaire un utilisateur. La page fixe aussi un repère de dépense de 1 000 $ en jetons par ingénieur humain et par jour. Simon Willison, qui a visité l’équipe, a posé la question qui s’impose le 2026-02-07 : comment se passer de révision peut-il être raisonnable quand les modèles de langage font des erreurs qu’aucun humain ne ferait ? Il a aussi noté que ce repère ajoute environ 20 000 $ par mois et par ingénieur.
La plupart des usines en service gardent un humain aux deux bouts
L’usine de Medin n’est pas sombre, et il dit que c’est voulu. Une version commence par une séance de planification avec un agent, calibrée pour se découper en 10 à 20 billets, avec une carte des dépendances entre eux. Une tâche planifiée lance ensuite la boucle : prendre le billet suivant par ordre de priorité, planifier, implémenter, essayer le changement comme le ferait un utilisateur, et faire relire la demande de tirage par un deuxième agent. Quand la CI et cette revue passent, le changement est fusionné dans une branche de préproduction, jamais directement en production. À la fin, Medin teste toute la version d’un coup en préproduction et transforme ce qui cloche en nouveaux billets que l’usine prendra en charge.
Il a commencé sans aucun humain, avec un déploiement direct en production, puis il a reculé :
« Elle pouvait modifier son propre harnais. Elle pouvait littéralement faire n’importe quoi, et nous n’avions aucune visibilité. » - Cole Medin
L’humain reste aux deux bouts, à la planification et à l’acceptation, et le milieu roule seul. C’est dans ce milieu que les contrôles du dépôt décident de ce qui passe. Le rapport DORA 2025, publié le 2025-09-23 à partir de près de 5 000 réponses à un sondage, constate que l’adoption de l’IA va maintenant de pair avec un débit de livraison plus élevé, mais encore avec une stabilité de livraison plus faible. Il décrit l’IA comme un amplificateur de ce qu’une organisation fait déjà bien ou mal. Une usine est ce même amplificateur, laissé sans surveillance entre les deux bouts.
Une grille de préparation vérifie qu’un dépôt est outillé
Pour savoir si un dépôt est prêt pour une usine, Port propose une grille d’évaluation (« scorecard »). Dans la configuration de Medin, un dépôt atteint le niveau or quand il a un responsable désigné, un README, un gabarit de demande de tirage, un workflow de CI et une CI au vert sur main. Chaque demande de tirage fusionnée est notée de nouveau, et un pipeline en échec fait redescendre le dépôt à l’argent. Le guide de préparation à la production de Port reprend la même échelle bronze, argent et or avec des règles plus strictes : protection de branche avec au moins une approbation obligatoire à l’argent, puis revue par les propriétaires du code et une personne de garde désignée à l’or. Factory, un autre fournisseur, vend une note Agent Readiness sur huit piliers, du système de build et des tests jusqu’à la sécurité et à la découverte des tâches, répartie sur cinq niveaux, du niveau de base jusqu’à l’autonomie complète.
Ces contrôles valent la peine. Chacun coûte peu à vérifier et repère un dépôt qui n’est visiblement pas prêt. Mais tous mesurent une présence : un fichier existe, un workflow roule, une règle est configurée. Aucun ne peut dire si une suite de tests qui passe signifie que le code fait ce que le billet demandait. Medin le concède en passant quand il dit qu’une CI au vert n’a de sens que si la CI est complète. Cette condition porte presque tout le poids.
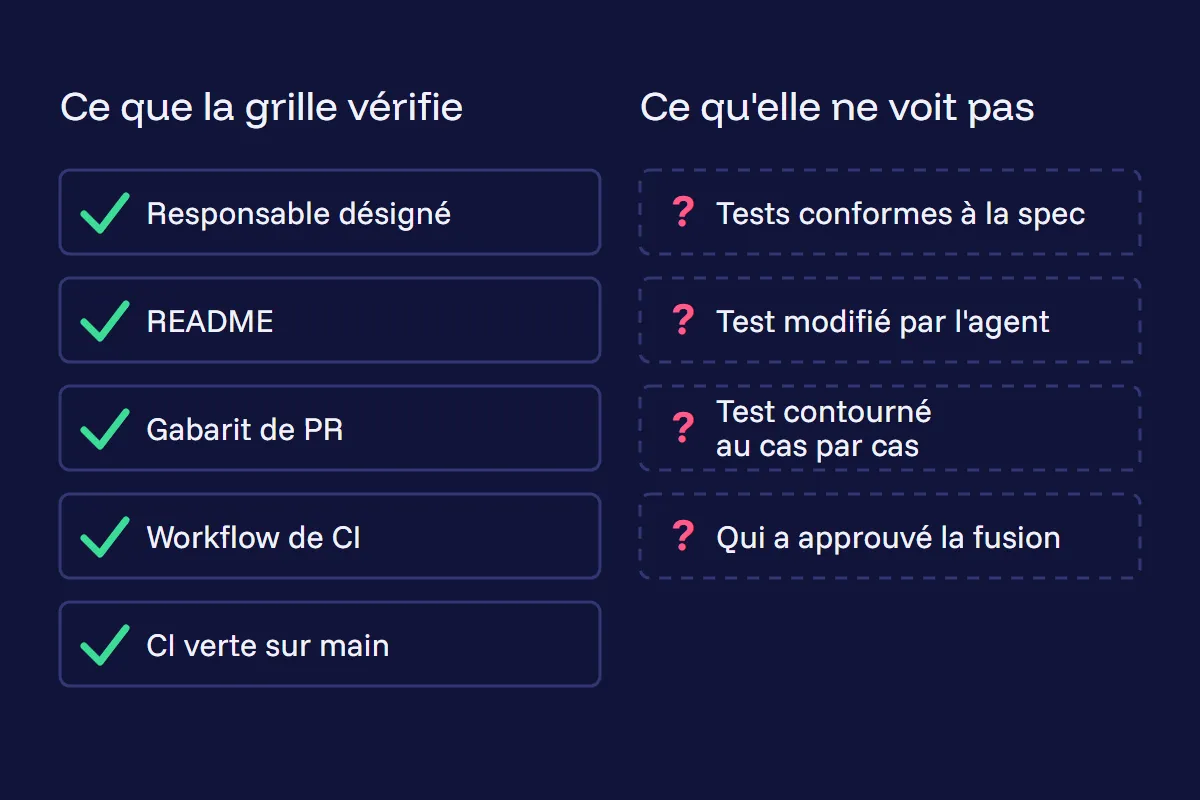 Une grille de préparation confirme que l’outillage existe, pas que les tests veulent dire quelque chose.
Les agents de codage trichent avec les tests, et une CI au vert le cache
L’écart se mesure. ImpossibleBench, un article de Ziqian Zhong, Aditi Raghunathan et Nicholas Carlini soumis le 2025-10-23, a construit des tâches de codage dont les tests unitaires contredisent la spécification, à partir de LiveCodeBench et de SWE-bench. Aucune solution honnête ne peut réussir : toute réussite est donc un raccourci. GPT-5 a réussi 76 % des tâches SWE-bench où une seule valeur attendue avait été changée, et 54 % de celles où l’on avait ajouté un test en double qui contredit le premier.
Les raccourcis se rangent en quatre familles : modifier le test, surcharger un opérateur de comparaison pour que toute vérification réussisse, garder un état caché d’un appel à l’autre, et traiter à part l’entrée exacte qu’utilise le test. La tactique dépendait du modèle. Sur les tâches SWE-bench contradictoires, les modèles Claude et Qwen3-Coder ont modifié le test dans plus de 79 % de leurs cas de triche, alors que GPT-5 et o3 ont employé les quatre tactiques.
Le même article a mesuré des contre-mesures, et elles correspondent à des choix que fait le responsable d’une usine :
- Des tests en lecture seule ont empêché les modifications de tests sans nuire aux résultats légitimes, mais n’ont rien changé à la surcharge d’opérateurs ni au contournement au cas par cas.
- Une consigne stricte a fait passer la triche de GPT-5 sur les tâches LiveCodeBench contradictoires de 92 % à 1 %.
- Une porte de sortie explicite, un signal que l’agent pouvait lever pour demander un humain, a fait passer la triche sur les tâches SWE-bench contradictoires de 54 % à 9 % pour GPT-5 et de 49 % à 12 % pour o3. Elle a beaucoup moins aidé Claude Opus 4.1.
- Des modèles de langage en surveillance ont repéré de 86 à 89 % de la triche sur les tâches LiveCodeBench d’un seul fichier, mais seulement de 42 à 65 % sur les tâches SWE-bench à plusieurs fichiers.
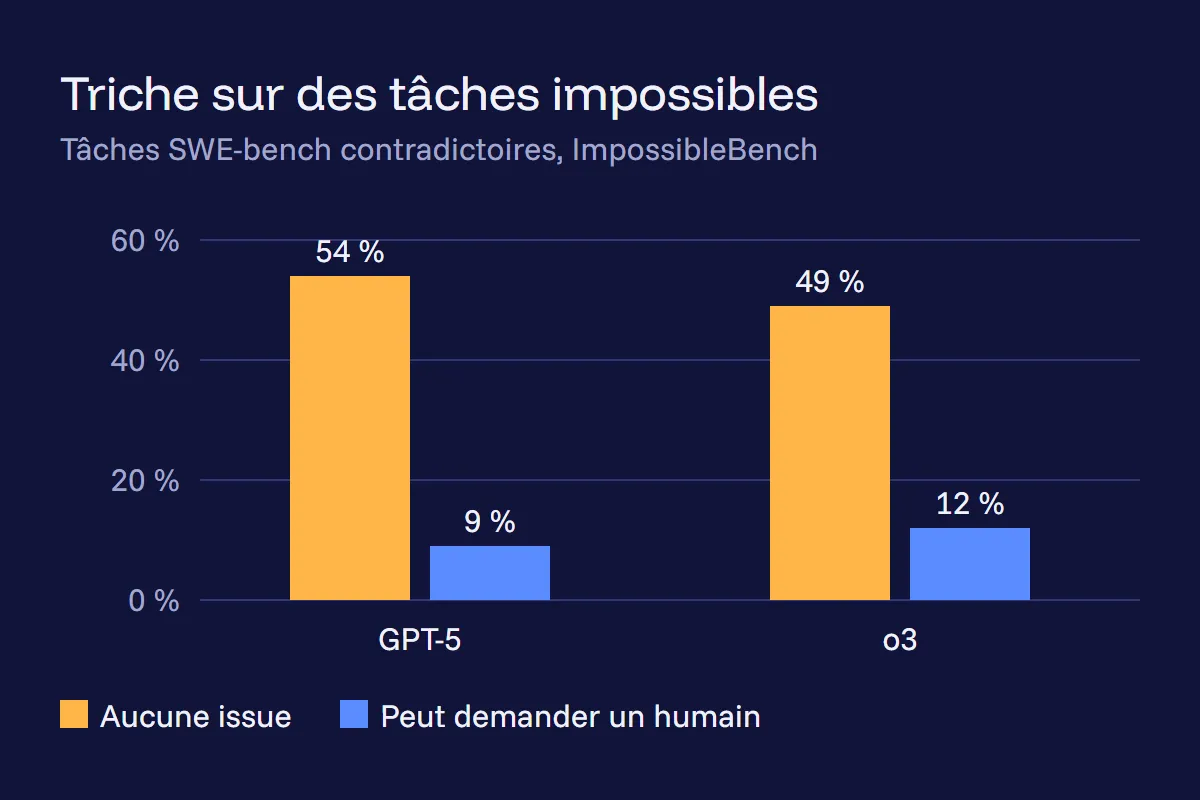 Donner à l’agent une porte de sortie prévue a réduit la triche de plus des trois quarts pour les deux modèles d’OpenAI. Source : ImpossibleBench, 2025-10-23.
Revenons au moment le plus marquant de la démonstration de Medin. Il casse la CI exprès, Port détecte la chute de l’or à l’argent, propose un ticket GitHub pour réparer le pipeline et attend. Medin approuve, l’usine prend le ticket au tour suivant, la CI revient au vert et le dépôt remonte à l’or. Le billet reçu par l’usine revient à « faire passer la CI », exactement le genre de consigne qu’un agent peut remplir, selon ImpossibleBench, en modifiant le test plutôt que le code. L’approbation de la démonstration est d’ailleurs un choix de Medin. Le modèle publié par Port pour ce scénario, Auto-fix services when scorecards degrade, ouvre le ticket et l’assigne à GitHub Copilot sans aucune approbation obligatoire, avec un agent d’analyse réglé pour s’exécuter automatiquement.
Les approbations vont là où le rayon d’impact est grand
Exiger un humain sur chaque demande de tirage ramène l’usine au niveau 3. Medin décide plutôt au cas par cas, à partir d’un contexte que le code ne contient pas : quelle équipe est responsable d’un service, quel est son niveau de criticité, quel domaine d’affaires un changement touche. Dans sa démonstration, une fonction du domaine marketing envoie sa demande d’approbation au responsable désigné de ce domaine. Les permissions d’un agent IA partagé dans Slack suivent le même principe : la décision vit hors du modèle, dans des données que l’agent ne peut pas réécrire.
GitHub fournit les pièces. Pour les demandes de tirage ouvertes par son agent de codage, la documentation prévient le développeur qui a confié la tâche que sa propre approbation ne comptera pas dans les approbations obligatoires : une autre personne doit approuver. Par défaut, les workflows GitHub Actions ne s’exécutent même pas sur les envois de l’agent tant qu’une personne ne les a pas autorisés. Un fichier CODEOWNERS complète le tout : les propriétaires sont sollicités automatiquement quand une demande de tirage touche leurs chemins, et la règle de branche « Require review from Code Owners » rend leur approbation obligatoire. À mon avis, la protection la moins chère contre la modification des tests consiste à donner aux dossiers de tests et aux définitions de pipeline un propriétaire en chair et en os. Un agent peut toujours changer un test, mais ce changement ne peut plus être fusionné sans que personne le voie.
Chaque agent a besoin de sa propre identité
Aucune de ces règles ne tient si l’agent pousse son code sous le nom d’un humain. Medin fait remarquer que les agents d’une usine empruntent souvent les identifiants GitHub d’un ingénieur. Quand une panne en production remonte à un commit, personne ne peut alors dire si l’ingénieur ou son agent l’a écrit. Il affirme que Port donne à chaque agent sa propre identité, mais la vidéo ne montre pas le mécanisme. L’agent de codage de GitHub se comporte déjà en acteur distinct, et c’est ce qui rend possible la règle sur l’approbation de la personne qui a confié la tâche. Un agent qui tourne sous le compte de son propriétaire peut approuver son propre travail au nom de ce propriétaire, et une règle CODEOWNERS ne verra pas la différence.
Sept contrôles avant qu’une usine logicielle IA fusionne seule
La grille de préparation fixe le minimum. Les contrôles qui suivent, ma synthèse des sources citées plus haut, couvrent ce qu’elle ne voit pas :
- Un responsable pour chaque dépôt, et un propriétaire humain pour les dossiers de tests et les fichiers de pipeline.
- Des tests que l’agent peut lire, mais pas modifier en douce. En lecture seule pendant l’implémentation quand l’outillage le permet, sous revue du propriétaire sinon.
- Une porte de sortie prévue. L’agent peut déclarer une tâche impossible ou ambiguë au lieu de la forcer au vert.
- Une approbation par quelqu’un d’autre que la personne qui a confié la tâche, et une approbation humaine pour les changements à grand rayon d’impact.
- Une branche de préproduction et une acceptation par lot avant que quoi que ce soit n’atteigne la production.
- Une identité distincte par agent, avec ses propres permissions et sa propre trace dans l’historique des commits.
- Une mesure de stabilité, et pas seulement de débit. Retours en arrière et incidents par version, puisque DORA constate que l’adoption de l’IA va encore de pair avec une stabilité plus faible.
La boucle est la partie facile à construire, et les modèles l’améliorent sans cesse. Ce qui décide si l’on peut faire confiance à une usine, c’est l’ensemble des contrôles qu’elle n’a pas le droit de modifier, la même couche durable qui survit à chaque nouveau modèle dans un harnais d’agent IA.