Modèle de décision Jev ou un LLM à sortie structurée
Les modèles de décision forment une classe de modèles d’IA qui lisent une situation et retournent une réponse choisie dans une liste que vous définissez, avec une probabilité, au lieu d’écrire du texte. Le modèle de décision Jev, lancé par TypeSafe en septembre 2026, est le premier vendu sous cette bannière. Cet article compare Jev à ce que fait déjà un grand modèle de langage quand on le contraint à une sortie structurée, distingue les affirmations mesurées du fournisseur de son marketing, et se termine par un test pour savoir quelles questions confier à quel modèle.
La comparaison compte surtout là où un système pose la même petite question des milliers de fois par jour, et un agent de codage en est le cas le plus clair. Claude Code peut exécuter un hook PreToolUse avant chaque appel d’outil, et ce hook bloque l’appel en sortant avec le code 2 ou en retournant une décision « deny » (référence des hooks de Claude Code). Chaque vérification est une question fermée : cette commande expose-t-elle un secret, supprime-t-elle des données, envoie-t-elle quelque chose à l’extérieur? Dans une vidéo sur l’utilisation de Jev dans les flux de travail de codage avec IA, publiée le 2026-09-30, Cole Medin raconte avoir remplacé sa propre garde, une longue liste d’expressions régulières, par Jev. Selon ses mesures, qu’il n’a pas publiées en détail, une vérification confiée à Claude Haiku prenait plus d’une seconde et coûtait environ un dixième de cent, alors que Jev répondait en un quart de seconde environ, pour une petite fraction de ce prix.
Un modèle de décision Jev répond à des questions typées, pas à des requêtes
Jev reçoit deux entrées : un état, c’est-à-dire la situation sous la forme non structurée où l’application la détient, et des questions typées sur cet état. OpenRouter, qui sert le modèle sous le nom typesafe/jev-1.14, documente quatre types de questions (Jev sur OpenRouter) :
- Choice choisit une option dans un ensemble et retourne une probabilité pour chaque option.
- Noul répond à une condition par oui ou non, avec la probabilité qu’elle soit vraie.
- Score place l’entrée sur une échelle ordonnée et retourne une position pondérée par les probabilités.
- Box repère un objet dans une image, en version 1.14 seulement.
Jev répond à toutes les questions en un seul appel, et les réponses reviennent sous forme de valeurs sur lesquelles un programme peut bifurquer sans analyse syntaxique. La même page précise que Jev ne produit aucune trace de raisonnement, aucune explication et aucun texte libre. Le fondateur de TypeSafe, Diogo Almeida, décrit l’usage visé comme des « if intelligents » : classer, aiguiller, noter, extraire, bifurquer (Introducing System One Models & Jev, 2026-09-15).
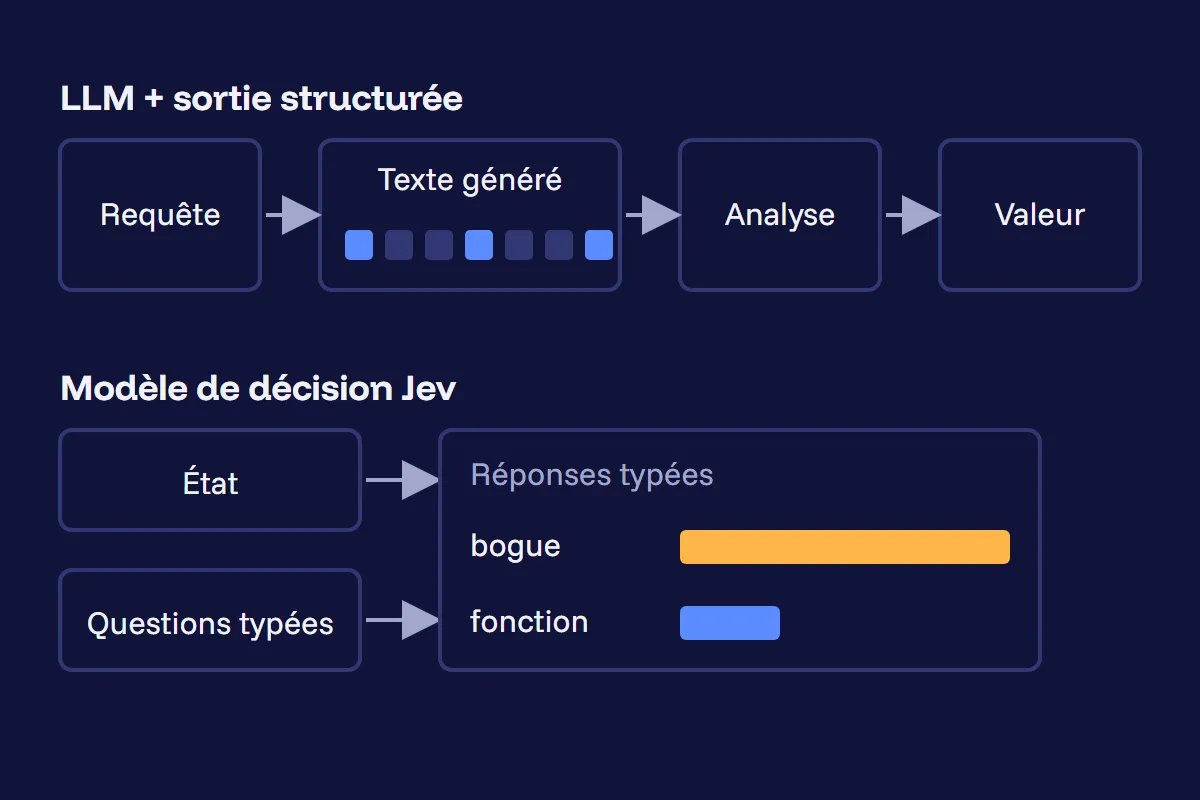 Un LLM à sortie structurée et Jev aboutissent au même genre de valeur, mais seul Jev se passe du texte généré et attache une probabilité à chaque option.
Le nom System One, comme le dit le billet de lancement lui-même, emprunte au mode de pensée rapide et intuitif décrit par Daniel Kahneman. Un modèle qui raisonne par écrit avant de répondre incarne le mode lent. Jev se veut le réflexe.
La sortie structurée donne déjà à un LLM le même format de réponse
Une réponse typée n’a, en soi, rien de nouveau. La fonction de sorties structurées d’Anthropic compile un schéma JSON en grammaire et contraint l’échantillonnage de Claude à cette grammaire, de sorte que la réponse s’analyse correctement et que ses champs portent les types déclarés (sorties structurées de Claude). Un enum de réponses permises fait partie des schémas pris en charge, et une question Choice n’est rien d’autre. La garantie comporte des exceptions documentées, comme les refus et les réponses coupées par max_tokens.
Un LLM sait donc déjà répondre « bogue ou fonction » sous une forme exploitable par le code, et Medin a d’ailleurs essayé sa garde avec un LLM avant d’adopter Jev. Ce qui change, c’est le prix, la latence et surtout la probabilité attachée à chaque réponse.
La probabilité est le produit, et la confiance d’un LLM est mal calibrée
Une probabilité permet à un logiciel d’agir seul au-dessus d’un seuil et de passer la main à une personne en dessous, mais seulement si elle est calibrée : les réponses données avec 90 % de confiance devraient être justes environ 90 % du temps.
Les modèles de langage perdent justement cette propriété pendant le post-entraînement. Le rapport technique de GPT-4 d’OpenAI trace la calibration sur un sous-ensemble du banc d’essai MMLU : l’erreur de calibration attendue passe de 0,007 pour le modèle préentraîné à 0,074 après le post-entraînement, et le rapport affirme que le post-entraînement nuit nettement à la calibration (GPT-4 Technical Report, arXiv:2303.08774). Une étude portant sur des modèles entraînés par RLHF, dont ChatGPT, GPT-4 et Claude, a constaté que la confiance exprimée en mots était généralement mieux calibrée que leurs probabilités de jetons, ce qui réduisait souvent l’erreur de calibration d’environ la moitié (Tian et al., EMNLP 2023). Les probabilités d’un modèle conversationnel ne sont pas fiables d’office.
L’affirmation centrale de TypeSafe, c’est que Jev règle ce problème. Le billet de lancement indique que le modèle est entraîné par une méthode que l’entreprise appelle Reinforcement Learning for Calibrated Decisions, et promet qu’une confiance plus élevée signifie une exactitude plus élevée. Il ne publie ni courbe de calibration, ni erreur de calibration, ni description de la façon dont la calibration a été mesurée. Pour un produit dont la valeur repose sur ses probabilités, c’est la plus grande lacune du dossier public.
Les chiffres de vitesse et de coût de TypeSafe viennent de ses propres évaluations
Le billet de lancement est plus prudent avec les chiffres que la plupart des articles qui l’ont repris. Il annonce des réponses de 40 à 200 fois plus rapides que celles des LLM de pointe pour les requêtes « de forme System One » : de 70 à 500 millisecondes pour Jev, contre 3 à 329 secondes de bout en bout pour les modèles de pointe. La page d’accueil affiche en manchette 193,6 fois plus rapide et 444,6 fois moins cher, des chiffres que le billet attribue à ses évaluations sur des flux de travail et situe dans le haut de la fourchette des gains réels. La fourchette de 40 à 1 000 fois moins cher que reprend Medin, et que Techstrong.ai attribue à TypeSafe, n’apparaît pas dans le billet de lancement.
La grille de prix est plus facile à vérifier. Jev coûte 0,042 $ par million de jetons d’entrée, et les jetons de sortie sont gratuits. Le billet met ce prix en regard de 0,20 $ à 10 $ par million de jetons d’entrée pour les LLM de pointe, dont les jetons de sortie coûtent environ cinq fois le prix d’entrée. Sur l’entrée seule, Jev est donc environ de 5 à 240 fois moins cher, avant même de compter les jetons qu’un LLM dépense pour rédiger sa réponse.
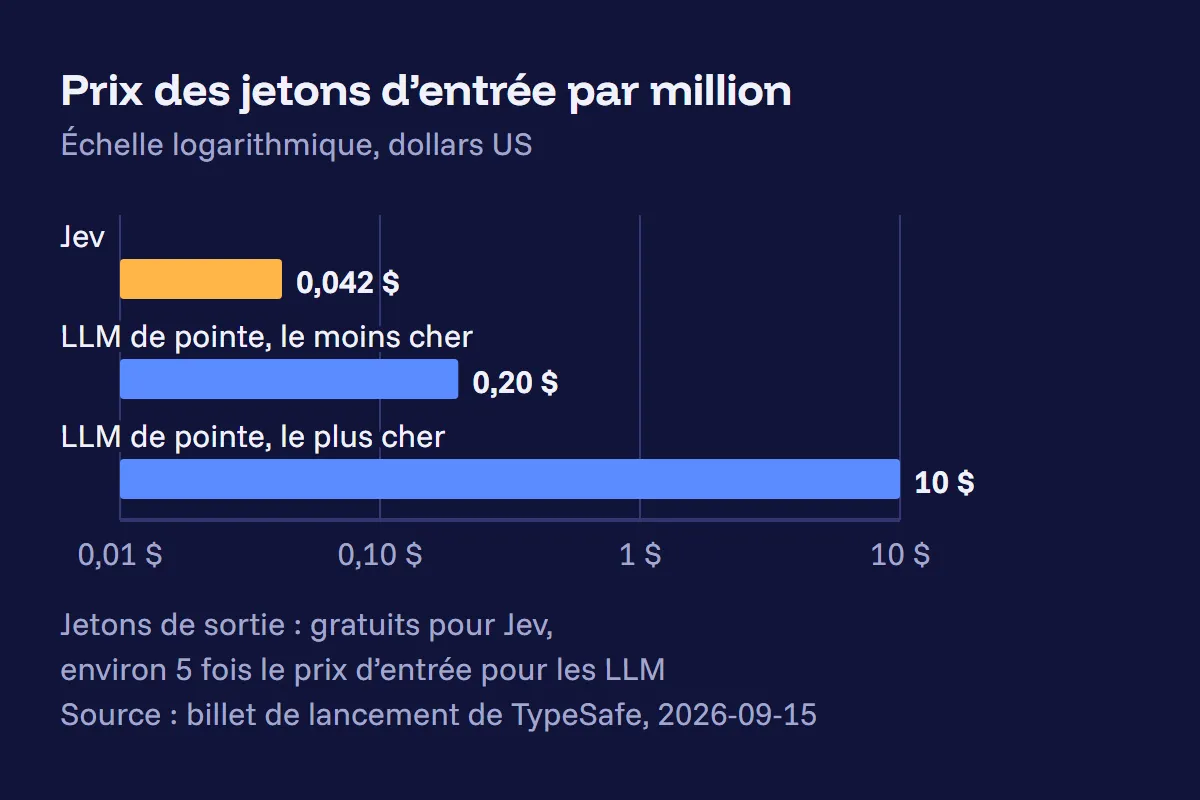 Le prix d’entrée de Jev se situe environ de 5 à 240 fois sous celui des LLM de pointe de la comparaison de TypeSafe. Source : billet de lancement de TypeSafe, 2026-09-15.
La conception de l’évaluation compte autant que le chiffre vedette. Dans les tests sur des flux de travail, les réponses de référence étaient la moyenne des probabilités de GPT-6 Astra et de Fable 5.1 : une bonne réponse signifie donc être d’accord avec deux autres modèles, pas avec des réponses vérifiées. L’équipe de TypeSafe a écrit elle-même ces flux, ce qui peut biaiser les résultats, le billet le concède, et l’entreprise reconnaît ne pas pouvoir prouver que son prix n’est pas subventionné. Côté exactitude, elle revendique la parité avec les LLM existants sur ces tâches, pas la supériorité. Aucun des articles cités ici ne fait état d’un banc d’essai indépendant.
Qu’un classificateur spécialisé batte un LLM généraliste n’a rien de nouveau
Un modèle conçu pour décider qui surpasse un modèle généraliste sur des décisions, c’est un constat ancien. En 2024, Martin Juan José Bucher et Marco Martini ont montré que des modèles plus petits, ajustés par entraînement, surpassaient encore de façon constante et significative de grands modèles génératifs utilisés sans exemple (zero-shot) en classification de texte (arXiv:2406.08660). Un classificateur ajusté est rapide et peu coûteux lui aussi, mais il exige des données étiquetées et un entraînement pour chaque nouvelle question. Jev promet la vitesse d’un classificateur avec la souplesse d’une requête : des questions définies au moment de l’appel, sans entraînement. Reste à savoir si un modèle de décision généraliste peut égaler des classificateurs spécialisés sur n’importe quelle question, et c’est précisément ce que les bancs d’essai manquants devraient établir.
Où un modèle de décision Jev trouve sa place dans un flux de codage avec IA
La vidéo de Medin vaut davantage pour son catalogue que pour ses chiffres : quatre endroits du développement logiciel assisté par IA où un flux de travail s’arrête pour poser une question fermée.
- Surveiller les appels d’outils. Sa garde pose quatre questions à chaque appel : des secrets sont-ils exposés, des données détruites, des données envoyées à l’extérieur, l’agent s’est-il écarté de sa tâche? L’état comprend le nom de l’outil, son effet, ses arguments et le répertoire de travail.
- Jouer à un jeu en cours de test. À 30 ou 60 images par seconde, un modèle qui écrit du texte ne peut pas choisir le coup suivant à temps. Jev contrôle le personnage d’un jeu que Medin développe, après qu’un LLM a écrit le harnais qui traduit l’état du jeu en entrée pour Jev.
- Piloter un navigateur. Pour les tests de bout en bout d’une application web, Jev choisit le champ à remplir et le bouton sur lequel cliquer, tandis qu’un LLM prépare le texte à saisir.
- Trier le travail. Dans un flux construit avec Archon, son outil open source de construction de harnais, Jev lit un ticket GitHub, décide s’il s’agit d’un bogue ou d’une fonction, et choisit le niveau de modèle dont l’étape suivante a besoin.
Ses résultats de triage sont modestes et jugés par lui seul : les 12 exécutions ont toutes concordé avec son propre avis, et un classificateur semblable pour les demandes de tirage (pull requests) a vu juste 15 fois sur 16, Medin restant le seul juge. C’est un premier essai raisonnable, pas une preuve d’exactitude.
Le schéma qu’il en dégage est ce qu’il faut retenir : un LLM prépare la décision en écrivant l’état et les options, et un LLM agit sur le résultat, en corrigeant le bogue qu’une partie a révélé ou en cherchant un autre chemin après un appel bloqué.
« Jev n’est jamais vraiment la fin de notre flux de travail. Il ne fait que rendre certaines parties de nos flux plus rapides et plus efficaces. » - Cole Medin
Le tableau comparatif de TypeSafe va dans le même sens, en laissant aux LLM les agents conversationnels, les copilotes et les agents de codage. C’est l’organisation en couches d’un harnais d’agent IA, où le modèle n’est qu’un composant parmi la boucle, les outils et les vérifications.
Ce qu’une garde probabiliste ne peut toujours pas promettre
C’est dans la garde que les compromis pèsent le plus lourd, parce qu’un modèle de décision chargé d’une tâche de sécurité en hérite de toutes les limites.
- Elle ne peut pas expliquer un blocage. Jev retourne une probabilité, pas une raison : la seule explication qu’un hook peut renvoyer est le nom de la question qui a franchi le seuil.
- Un délai dépassé laisse passer l’appel. La référence des hooks précise qu’un hook de type commande ou HTTP qui dépasse son délai ne bloque pas l’appel d’outil, sauf s’il est configuré pour bloquer en cas d’échec.
- Les seuils valent pour une seule version du modèle. OpenRouter prévient que les probabilités diffèrent d’un modèle à l’autre : un seuil réglé sur Jev 1.13 doit être revérifié sur 1.14.
- Les longues entrées dégradent les réponses. Au-delà d’environ 32 000 octets de texte, Jev passe à un mode à long contexte que TypeSafe qualifie lui-même de plus lent et moins exact.
- Les arguments quittent la machine. Une garde censée tenir les secrets hors du contexte d’un agent envoie chaque appel d’outil, arguments compris, à une API tierce.
Seule la première limite est propre à Jev. Un juge LLM placé dans le même hook subit toutes les autres. C’est pourquoi les permissions d’un agent IA doivent être appliquées hors du modèle : un classificateur, aussi rapide soit-il, est un filtre placé devant les permissions, pas leur remplaçant.
Choisir selon la forme de la question, pas selon le modèle
Une question convient à un modèle de décision quand ses réponses peuvent être énumérées à l’avance, quand elle revient assez souvent pour que le coût et la latence s’accumulent, quand une seconde de délai casse quelque chose, et quand le programme a besoin d’une probabilité pour fixer un seuil. Elle convient à un LLM quand la réponse est du texte, quand quelqu’un doit lire le raisonnement, ou quand la question est assez rare pour que le coût et le délai n’aient pas d’importance.
La plupart des flux de travail contiennent les deux sortes de questions, et c’est pourquoi le sandwich est l’architecture réaliste. Avant de confier une décision à Jev, soumettez les mêmes questions aux deux modèles sur un échantillon dont vous connaissez les réponses, comparez l’exactitude et la calibration plutôt que la seule vitesse, et fixez le seuil à partir de ces données. TypeSafe a publié sa vitesse et son prix. La calibration, sur laquelle repose tout son argument, c’est à vous de la mesurer.