Harnais d'agent IA : ce qui survit au prochain modèle
Un harnais d’agent IA, c’est le logiciel qui transforme un modèle de langage en agent : la boucle qui appelle le modèle, les outils qu’il peut utiliser, la façon dont le contexte est élagué et transporté d’une session à l’autre, les permissions qui encadrent chaque action et les vérifications qui décident quand une tâche est terminée. Cet article examine où se trouvent réellement la performance et l’argent dans cette couche, en s’appuyant sur des données de référence, le parcours d’Harvey dans l’IA juridique et les mouvements des laboratoires de modèles en 2026. Il se termine par un test pratique pour distinguer une entreprise de harnais durable de celle que la prochaine sortie de modèle va effacer.
La question est d’actualité parce que fondateurs et investisseurs considèrent maintenant le harnais comme l’endroit où bâtir. Dans une vidéo listant treize types d’entreprises à posséder à mesure que les agents se répandent, publiée le 2026-10-06, Greg Isenberg place les harnais spécifiques à un domaine dans sa liste et les présente comme le prochain chapitre d’une histoire familière :
« Je crois que les harnais sont les nouveaux wrappers GPT. » - Greg Isenberg
Son argument, c’est que les meilleurs des premiers wrappers ne sont pas morts. Ils ont gardé le modèle en dessous et empilé par-dessus des outils propres à leur industrie, des règles de processus et de la mémoire jusqu’à devenir quelque chose de plus solide. Cette affirmation est à moitié vraie, et la moitié qui est fausse compte davantage pour quiconque décide quoi bâtir.
Un harnais d’agent IA, c’est tout ce qui entoure les poids
L’image qu’utilise Isenberg lui-même, c’est une voiture : le modèle est le moteur, et le harnais, c’est le reste du véhicule. L’analogie tient mieux qu’il ne le laisse entendre, parce que les fournisseurs décrivent maintenant leurs produits dans les mêmes termes. La documentation d’Anthropic présente son Agent SDK comme la boucle d’agent, les outils et la gestion du contexte de Claude Code emballés en bibliothèque, et énumère ce qui l’accompagne : des outils intégrés, des hooks qui exécutent du code personnalisé à des moments précis du cycle de vie de l’agent, des sous-agents, des connexions à des systèmes externes via le Model Context Protocol, des permissions qui déterminent quels outils s’exécutent sans approbation, des sessions reprenables et une mémoire chargée à partir des fichiers de projet (Aperçu de l’Agent SDK). Le blogue d’ingénierie d’Anthropic appelle ce même SDK un harnais d’agent à usage général (Justin Young, Anthropic, 2025-11-26), et OpenAI a intitulé une publication de février 2026 sur la construction de logiciels avec Codex “Harness engineering”.
Le terme est bien établi dans les laboratoires. Ce qu’il recouvre se divise en trois groupes, et la suite de l’article s’appuie sur ce tri :
- Mécanique : la boucle, l’appel d’outils, le compactage du contexte, les reprises, les sessions.
- Contournements : chaînes de prompts, décomposition de tâches et listes de vérification qui existent parce que le modèle actuel échoue sans eux.
- Engagements envers un client : pour qui l’agent peut agir, à quoi il peut toucher, dans quels systèmes il écrit et comment un résultat est jugé correct.
Le regroupement est le mien, pas celui d’un fournisseur. Il importe parce que les trois groupes vieillissent à des rythmes très différents.
Le même modèle obtient des résultats différents dans un autre harnais
Le harnais n’est pas une décoration : il déplace les résultats. Une étude de 2026, présentée sous forme d’affiche à un atelier d’ICML sur les agents de codage, a fixé deux modèles (Qwen 3.6 Plus et MiniMax M2.5) et a fait tourner chacun à travers trois harnais à code ouvert, Goose, OpenCode et OpenHands-SDK, sur 50 tâches tirées de Terminal-Bench Pro (Vats et Golev, arXiv 2607.22585). En ne changeant que le harnais, les auteurs ont observé jusqu’à 40 fois plus de jetons dépensés par tâche résolue. Les taux de réussite ont beaucoup moins bougé, entre 0 et 8 points de pourcentage pour un modèle donné, et les auteurs rapportent que seul le plus grand de ces écarts dépasse leur intervalle de confiance. Chaque harnais a aussi laissé sa propre signature d’échec, comme atteindre la limite de tours ou boucler à vide, peu importe le modèle qui s’y trouvait.
Ce résultat joue dans les deux sens. Sur le coût, le harnais domine : un écart d’un facteur 40 en jetons sépare un produit rentable d’un produit qui ne peut pas l’être. Sur la précision, l’effet est réel mais modeste, ce qui devrait tempérer quiconque s’attend à ce qu’un échafaudage ingénieux rende fort un modèle faible.
Les expériences d’Anthropic avec des agents de codage de longue durée montrent la même tendance de l’intérieur. Ses agents échouaient de deux façons prévisibles. Soit ils tentaient de bâtir une application entière d’un seul coup et manquaient de contexte à mi-chemin, soit une session ultérieure voyait un progrès partiel et déclarait le travail terminé. Chaque correctif relevait du travail de harnais : un agent initialisateur qui rédige une liste de fonctionnalités, un script de démarrage, un journal de progression et un premier commit ; une seule fonctionnalité par session par la suite ; et une règle voulant qu’une fonctionnalité ne soit considérée comme réussie qu’après un test de bout en bout piloté dans un navigateur (Anthropic, 2025-11-26). Rien de tout cela n’exigeait un modèle différent.
Harvey vend un harnais bâti sur les modèles de trois laboratoires
Harvey est le cas le plus clair d’un harnais de domaine devenu une grande entreprise. Le produit de cette compagnie d’IA juridique tournait sur les modèles d’OpenAI jusqu’en mai 2025, moment où elle a ajouté les modèles d’Anthropic via AWS Bedrock et ceux de Google via Vertex. Son annonce expliquait le changement par un résultat tiré de BigLaw Bench, son banc d’essai juridique propriétaire : en moins d’un an, sept modèles de fondation, dont trois extérieurs à OpenAI, avaient dépassé le système Harvey qu’elle avait d’abord évalué (Harvey, 2025-05-13). La conclusion qu’elle en tirait :
« Il n’existe plus un seul “meilleur” modèle, mais un éventail de modèles de premier plan. » - Harvey, 2025
En mars 2026, Harvey se décrivait comme multi-modèle par conception : elle achemine chaque tâche vers le modèle qui lui convient, bascule vers un autre fournisseur en cas de panne et décide de ces routages grâce à des tests continus sur BigLaw Bench et à des études de préférence menées par sa propre équipe de recherche juridique (Niko Grupen, Harvey, 2026-03-10). Le 2026-09-09, elle a annoncé une ronde de 550 millions de dollars à une valorisation de 15,5 milliards de dollars, codirigée par Diffusion et Lightspeed, et a indiqué que 80 % des cabinets Am Law 100 l’utilisent (Harvey, 2026-09-09).
Lue attentivement, cette histoire appuie la thèse d’Isenberg et la complique. La valeur d’Harvey ne réside clairement pas dans un seul modèle, puisqu’elle en loue trois. Mais le résultat de BigLaw Bench signifie aussi que des modèles prêts à l’emploi ont rattrapé le système original d’Harvey en moins d’un an. Ce qui a maintenu l’entreprise en avance, ce n’était pas son premier échafaudage. C’était le banc d’essai qui lui disait que l’échafaudage avait été dépassé, et les relations clients qui lui permettaient de changer de moteur sans perdre la voiture.
Les wrappers GPT minces ont perdu face au produit qu’ils enveloppaient
Le cas d’avertissement, c’est la première vague d’outils d’écriture IA. Jasper a levé 125 millions de dollars à une valorisation de 1,5 milliard en octobre 2022, environ sept semaines avant qu’OpenAI ne lance ChatGPT. En juillet 2023, elle procédait à des mises à pied et se repositionnait comme copilote pour les équipes marketing plutôt que pour les rédacteurs individuels, après que ChatGPT eut remodelé le marché dans lequel elle vendait (Eric Hal Schwartz, Voicebot.ai, 2023-07-17).
À ce stade, le produit de Jasper tenait surtout du deuxième groupe de composants : des gabarits et des chaînes de prompts qui tiraient de bons textes d’un modèle qu’il fallait amadouer. Une fois que l’interface du laboratoire lui-même a produit une qualité comparable pour moins cher, cet amadouage ne valait plus grand-chose. Le récit d’Isenberg sur des wrappers qui mûrissent en harnais est tiré des entreprises qui s’en sont sorties. Il ne dit rien sur le nombre de jeunes pousses qui ont ajouté outils et mémoire et ont tout de même plié boutique. Ce n’est pas un détail : c’est le problème de sélection sous-jacent à toute la thèse.
De meilleurs modèles effacent du code de harnais
Les contournements expirent. L’essai de Rich Sutton de 2019, “The Bitter Lesson”, soutenait qu’au fil de décennies de recherche en IA, les méthodes qui passent à l’échelle avec la puissance de calcul ont systématiquement battu celles qui encodent la connaissance humaine du problème. Un harnais rempli de décomposition de tâches construite à la main, c’est de la connaissance humaine du problème, et l’essai prédit ce qu’il advient d’elle.
Vercel en a documenté un cas. Son agent texte-vers-SQL interne, d0, comptait 17 outils spécialisés et ne répondait correctement qu’à quatre de ses cinq requêtes de test. L’équipe l’a reconstruit autour de Claude Opus 4.5 avec deux outils, un qui exécute des commandes shell et un qui exécute du SQL. Sur les mêmes cinq requêtes, il est passé à cinq sur cinq ; le temps d’exécution moyen a chuté de 274,8 à 77,4 secondes, les jetons d’environ 102 000 à environ 61 000, et les étapes d’environ 12 à environ 7 (Andrew Qu, Vercel, 2025-12-22). Cinq requêtes, c’est un petit échantillon, et la publication est un compte rendu de terrain, pas une étude. La direction demeure celle que Sutton avait prédite : un modèle plus fort a rendu l’essentiel du harnais inutile.
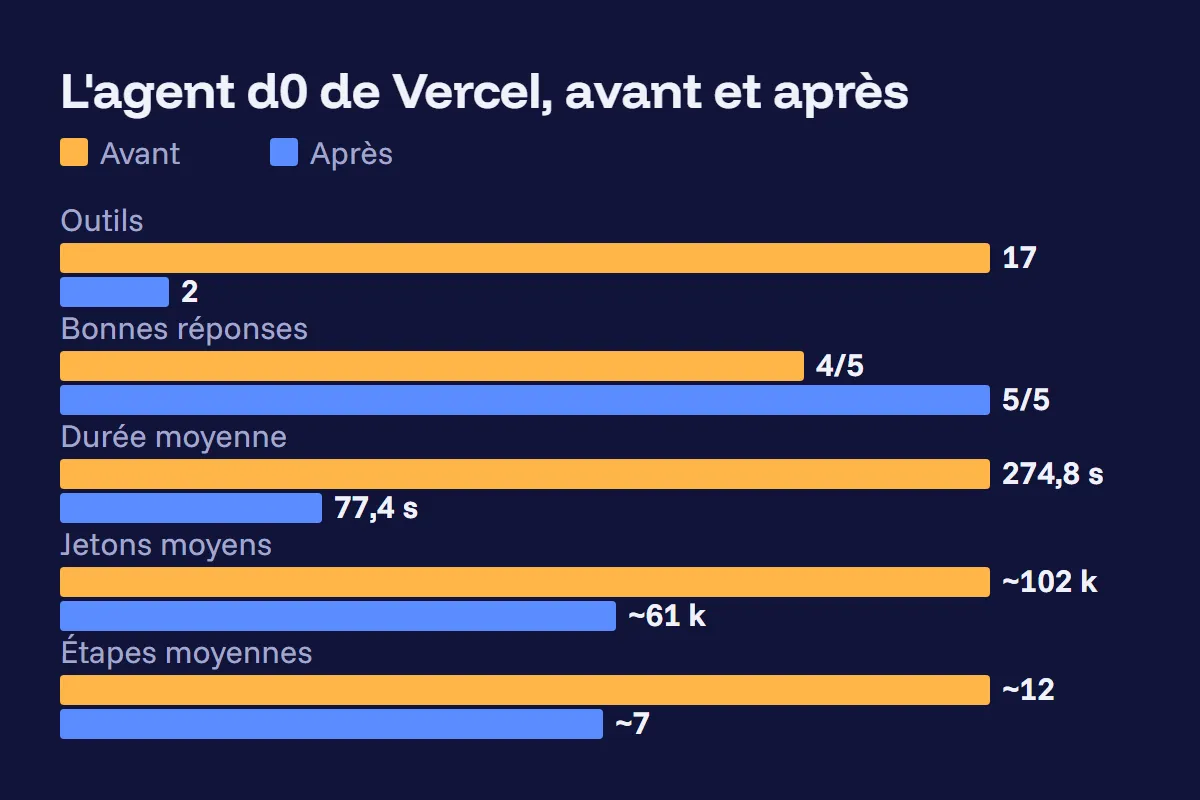 Avec moins d’outils et un modèle plus fort, d0 est devenu plus rapide, moins cher et plus précis sur ses cinq requêtes de test. Source : Vercel, 2025-12-22.
Les laboratoires livrent maintenant leurs propres harnais
Le groupe mécanique se fait absorber de l’autre côté. Anthropic vend le harnais de Claude Code sous le nom d’Agent SDK et, à travers Managed Agents, offre un harnais hébergé qui exécute la boucle d’agent dans un bac à sable qu’elle opère (Aperçu de l’Agent SDK). Une jeune pousse dont l’actif principal est une boucle d’agent bien construite se retrouve maintenant en concurrence avec la bibliothèque du fournisseur de modèle lui-même.
Les laboratoires s’avancent aussi dans les domaines. Le 2026-02-03, Anthropic a sorti un plugiciel juridique pour Claude Cowork qui gère la révision de contrats, le triage d’ententes de confidentialité et les vérifications de conformité, avec l’avertissement qu’un avocat autorisé à exercer doit réviser ce qu’il produit. eWEEK a rapporté que Thomson Reuters a perdu près de 18 % en une journée, RELX 14 % et Wolters Kluwer environ 13 % (eWEEK, 2026-02-04). Il s’agit d’acteurs établis plutôt que de jeunes pousses de harnais, et une chute d’une journée mesure la peur des investisseurs, pas des revenus perdus. Le signal est tout de même clair : un laboratoire peut publier un processus de domaine sous forme de plugiciel, et le marché y voit une menace pour tous ceux qui vendent le même processus.
Les évaluations, les permissions et les intégrations sont la couche durable
Ce qui survit, c’est le troisième groupe, les engagements envers un client particulier. Mon point de vue, tiré des cas ci-dessus plutôt que d’une source unique, c’est que trois parties d’un harnais résistent aux deux forces.
- Évaluations de domaine. BigLaw Bench a permis à Harvey de remarquer que les modèles avaient dépassé son système et de contourner le changement. Un laboratoire peut livrer un plugiciel juridique ; il ne peut pas livrer le jugement d’un cabinet particulier sur ce à quoi ressemble un bon mémo de fusion.
- Permissions liées à de vraies personnes. Quels dossiers client un agent peut lire, au nom de qui il agit et quelles actions attendent un humain, ce sont des décisions sur l’organisation du client, pas sur le modèle. C’est pourquoi les permissions d’agents IA doivent vivre à l’extérieur du modèle, et un modèle plus intelligent n’y change rien.
- Intégrations aux systèmes de référence. Écrire dans un logiciel de gestion de cabinet, un ERP ou une file de billets, avec la piste d’audit qu’un client réglementé exige, c’est du travail lent qui s’accumule au lieu d’expirer.
Chacun de ces éléments gagne en valeur à mesure que les modèles s’améliorent. On peut confier plus d’actions à un modèle plus fort, et chaque action supplémentaire a besoin d’une portée, d’une vérification et d’une destination.
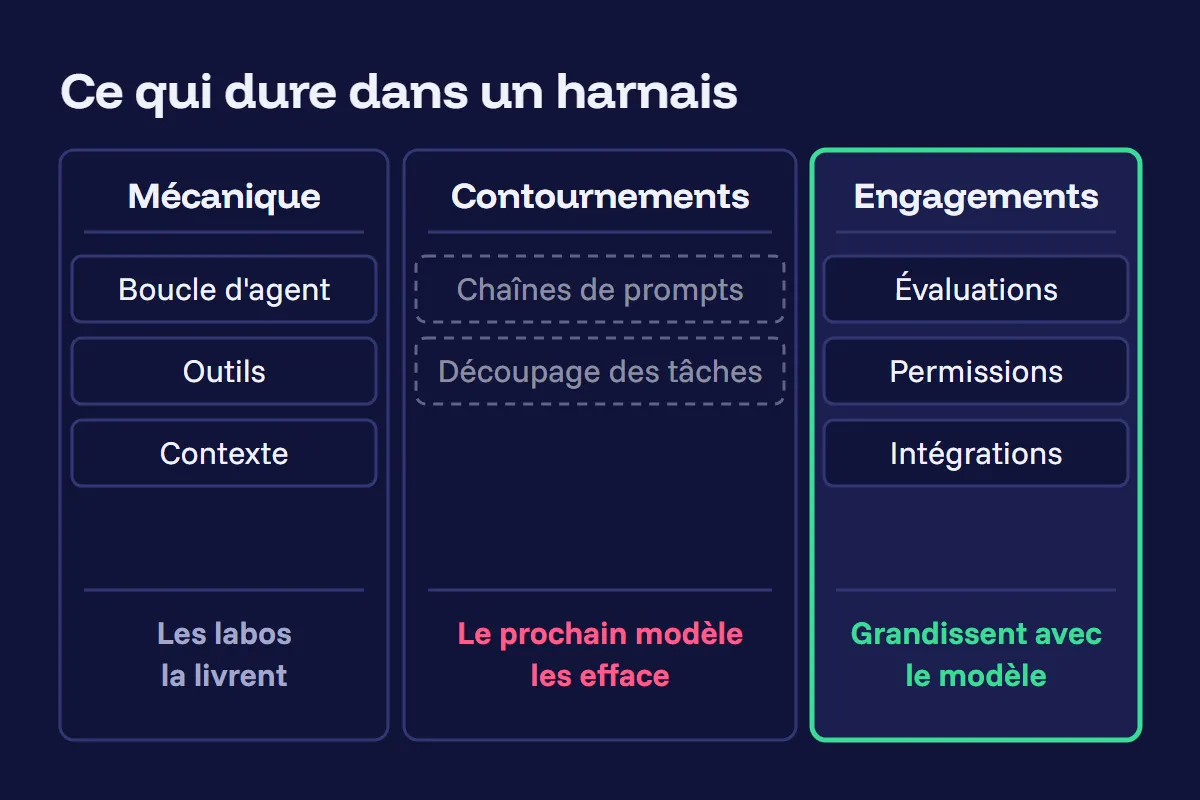 Parmi les trois groupes d’un harnais, seuls les engagements envers un client gagnent en valeur à mesure que les modèles s’améliorent.
Un test pour toute entreprise de harnais d’agent IA
Isenberg a raison de dire que le harnais est l’endroit où une entreprise d’IA verticale fait son travail, et la valorisation d’Harvey en est une preuve suffisante. Il a tort de le traiter comme une seule chose. Les trois groupes suggèrent un test simple : imaginez la prochaine sortie de modèle. Si elle vous permettait de supprimer du code, ce code était un contournement et sa valeur a toujours été temporaire. Si elle rendait votre suite d’évaluation, votre modèle de permissions et vos intégrations plus utiles, parce que l’agent peut maintenant se voir confier davantage, alors vous bâtissez la partie du harnais d’agent IA qui dure.