Questions de clarification d'un agent IA : quand les poser
Les questions de clarification d’un agent IA sont celles qu’il pose à une personne avant d’agir, pour établir ce qu’elle veut vraiment. Elles ont l’air d’une friction, et les équipes produit apprennent à éliminer la friction. Cet article examine quand une question rapporte et quand elle coûte plus qu’elle ne rapporte, à partir d’une expérience décrite par Gamma en octobre 2026, d’une étude de 2026 sur des agents de codage soumis à des tâches vagues, d’études menées auprès d’utilisateurs de moteurs de recherche et d’un banc d’essai de sécurité. Il se termine par des règles : quand un agent doit demander, combien de questions poser et de qui accepter les réponses.
L’expérience vient de Gamma, l’entreprise de présentations par IA qui a annoncé en novembre 2025 avoir dépassé 100 millions de dollars de revenus récurrents annuels avec 70 millions d’utilisateurs (communiqué de Gamma, 2025-11-10). Son cofondateur et chef de produit, Jon Noronha, l’a décrite dans une entrevue avec Greg Isenberg publiée le 2026-10-28. L’agent de Gamma commence normalement chaque demande par un court formulaire de questions, puis affiche un plan à réviser avant de construire quoi que ce soit. L’équipe a testé un mode rapide qui sautait ces deux étapes, en pensant que les gens arriveraient plus vite à une présentation finie et l’aimeraient davantage. Noronha a admis qu’il espérait que la théorie tienne :
« Je souhaitais vraiment que ce test réussisse. Je voulais le voir gagner, mais en fait il n’a pas gagné pour nous. » - Jon Noronha
Le mode rapide de Gamma a perdu face au parcours qui pose des questions d’abord
Selon Noronha, le parcours plus lent a produit des cotes de satisfaction plus élevées, des utilisateurs qui faisaient plus avec ce qu’ils avaient créé, et un meilleur taux de conversion vers un abonnement payant. Il n’a donné ni taille d’échantillon, ni taille d’effet, ni durée du test : il s’agit donc du témoignage d’une entreprise plutôt que d’un résultat publié. Deux détails méritent quand même d’être pris au sérieux. La conversion vers un abonnement payant est le signal auquel il se fie le plus, parce que personne ne paie par politesse. Et Gamma n’a pas jeté le mode rapide : l’entreprise en a mis en service une version pour les tout nouveaux utilisateurs sur mobile, où taper des réponses sur un petit écran est un vrai coût.
Ce second détail est le plus utile. Le test n’a pas montré que les questions sont bonnes en général. Il a montré que, pour les gens qui préparent une présentation à leur bureau, deux arrêts précis valaient leur temps, et que le compromis change selon l’appareil. Le reste de cet article cherche les conditions derrière ce résultat.
Les questions de clarification récupèrent presque tout ce qu’une tâche vague fait perdre
La mesure la plus nette vient du génie logiciel, où une tâche réussit ses tests ou non. Nicholas Edwards et Sebastian Schuster sont partis des 500 tâches de SWE-bench Verified, dans des versions de chaque problème réécrites pour en retirer les chemins de fichiers, les traces d’appels et les extraits de code. Des agents de codage se sont ensuite attaqués à ces tâches vagues, certains autorisés à interroger un utilisateur simulé, d’autres non (Edwards et Schuster, « Ask or Assume? », arXiv 2603.26233, EMNLP 2026).
Avec Claude Sonnet 4.5, un agent qui ne pouvait pas demander résolvait 54,8 % des tâches vagues. Permettre au même agent de demander a porté ce taux à 61,2 %. Répartir le travail entre un agent qui juge si la tâche est sous-spécifiée et un autre qui écrit le code l’a porté à 69,4 %, contre 70,8 % quand l’agent recevait le problème d’origine complet. Demander a récupéré presque tout le terrain que les détails manquants avaient fait perdre.
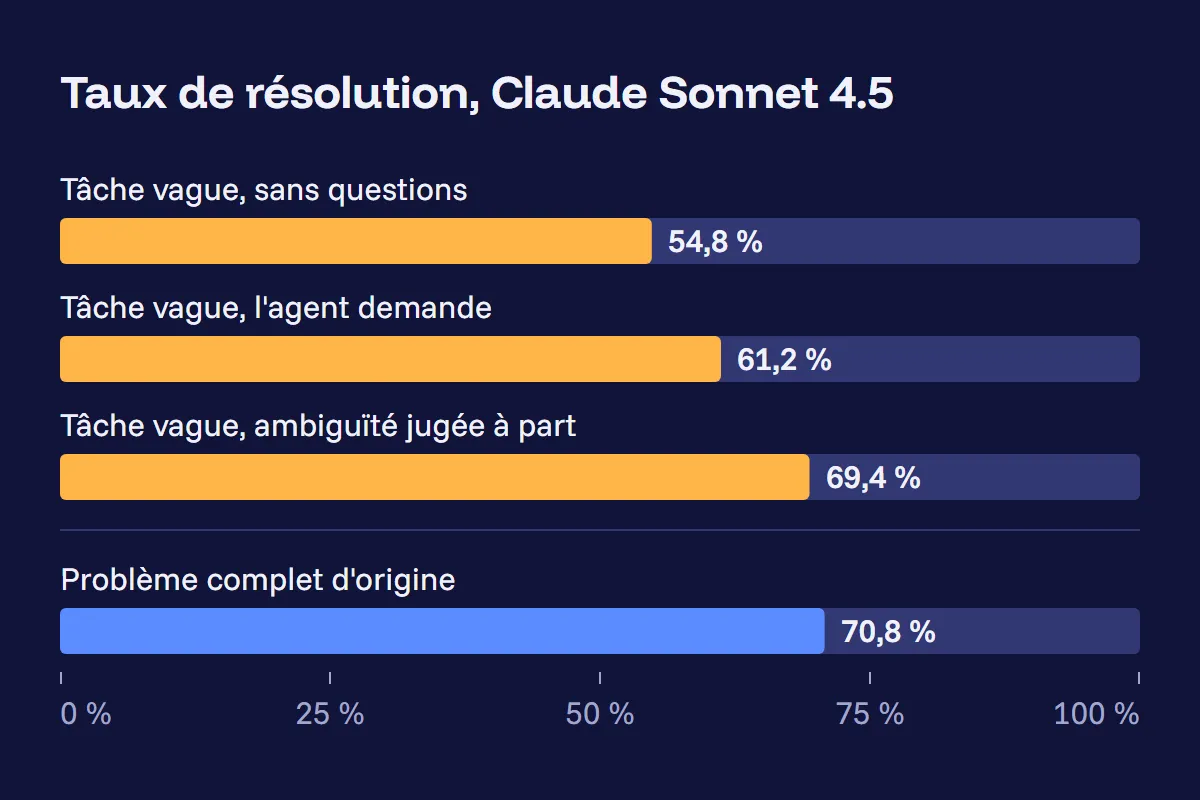 Laisser l’agent poser des questions a comblé la majeure partie de l’écart entre une tâche vague et une tâche complète. Source : Edwards et Schuster, arXiv 2603.26233.
Les auteurs signalent eux-mêmes la principale faiblesse : leur utilisateur simulé, joué par GPT-5.1, est plus coopératif que de vraies personnes. Les vrais utilisateurs répondent tard, répondent à moitié, ou ne connaissent pas la réponse. Les chiffres sont une borne supérieure de ce que les questions peuvent récupérer, pas une prévision pour un produit en service.
Plus de questions n’ont pas donné plus de précision
La même étude contient un avertissement. Avec le modèle à poids ouverts Kimi K2.6 à la place de Claude, la conception répartie atteignait aussi 69,4 %, mais elle posait en moyenne 8,71 questions par tâche, contre 3,06 pour Claude. Même résultat, presque trois fois plus d’interruptions. Les auteurs attribuent l’écart à un calibrage plus faible : le modèle jugeait moins bien quand il manquait vraiment d’information.
La recherche web avait appris la même leçon plus tôt, avec de vraies personnes. Jie Zou et ses collègues ont présenté à des utilisateurs des questions de clarification de qualité variable pendant des tâches de recherche. Les bonnes questions amélioraient à la fois la performance et la satisfaction. Les mauvaises et les moyennes empiraient les deux, au point que les auteurs suggèrent, dans ces cas, de laisser les utilisateurs continuer sans question (Zou et coll., ACM Transactions on Information Systems 41(1), 2023). Une question n’est jamais neutre. Une question vague ou hors sujet dit à l’utilisateur que le système n’a pas compris, et elle lui coûte un effort pour rien.
Une bonne question a une forme reconnaissable. Gamma teste son agent sur un cas précis : quand on lui demande une présentation sur les tigres, il doit savoir si le public est composé d’enfants ou d’adultes. La question a deux réponses, chacune mène à une présentation visiblement différente, et l’utilisateur connaît la réponse sur-le-champ. Anthropic a intégré une contrainte semblable dans son Agent SDK. En octobre 2026, son outil AskUserQuestion accepte d’une à quatre questions par appel, chacune avec deux à quatre options au choix (Anthropic, Handle approvals and user input). Le choix multiple oblige l’agent à faire le travail de réflexion et ne laisse à l’utilisateur qu’un clic.
Les questions ont leur place avant le travail, pas au milieu
Le moment compte autant que le nombre. La recherche approfondie de ChatGPT exécute une étape de clarification avant le début des recherches : un modèle intermédiaire cerne l’intention de l’utilisateur et rassemble le contexte manquant, puis la demande est réécrite en invite détaillée. Le guide d’OpenAI précise que la version de l’API n’a pas cette étape et laisse les développeurs construire la leur (OpenAI, Deep research guide). Anthropic décrit le mode plan de la même manière : Claude explore le code et pose ses questions avant de proposer un plan, pas pendant qu’il modifie les fichiers. Le formulaire de Gamma apparaît dans les premières secondes, avant la rédaction du plan.
La raison est le coût. Une question posée au début coûte quelques secondes à l’utilisateur et rien à l’agent. La même question posée vingt minutes après le début met en péril le travail déjà fait, et elle peut arriver à un utilisateur passé à autre chose. L’étude sur le codage en montre une version. Son agent unique posait 43,9 % de ses questions dans la dernière partie de son exécution, tandis que la conception répartie les posait surtout au début et au milieu, et obtenait un meilleur résultat. L’étude ne prouve pas que le moment explique l’écart, mais la tendance correspond à ce que font les produits.
Réviser un plan donne aux gens une part du résultat
Le résultat de Gamma n’est pas qu’une affaire de précision. Noronha soulignait que les personnes qui répondaient aux questions et révisaient le plan se sentaient plus investies dans leur présentation et en faisaient plus. Les sciences du comportement ont un nom pour un phénomène proche. Dans quatre études où des participants assemblaient des boîtes IKEA, pliaient des origamis ou construisaient des ensembles Lego, Michael Norton, Daniel Mochon et Dan Ariely ont constaté que les gens accordaient plus de valeur à ce qu’ils avaient fait eux-mêmes, et jugeaient leur travail d’amateur proche de celui d’experts (Norton, Mochon et Ariely, Journal of Consumer Psychology 22(3), 2012).
Appliquer cela à un agent relève de ma propre lecture : ni l’une ni l’autre source ne l’a testé. Une étape de révision laisse une personne façonner le résultat avant qu’il existe, ce qui le rend en partie sien. L’étude ajoute une condition qui compte pour la conception d’un produit : l’effet disparaissait quand les participants ne terminaient pas ou quand leur création était défaite. Un parcours de questions qui aboutit à une présentation dont l’utilisateur est fier crée de l’attachement. Un parcours qui s’enlise, ou qui produit quelque chose que l’utilisateur jette, ne crée rien.
Chaque réponse à un agent est aussi une surface d’attaque
La clarification a un coût qui échappe aux études auprès des utilisateurs. Des chercheurs de Scale AI ont construit ASPI, un banc d’essai de 728 scénarios associant une tâche et une attaque, et ont fait travailler dix modèles de pointe sur des tâches ambiguës, avec et sans la possibilité de demander des précisions. Demander des précisions a rendu les injections d’invite beaucoup plus efficaces. Pour o3, le taux de réussite des attaques est passé de 1,8 % à 34,0 % ; pour Gemini 3 Flash, de 2,2 % à 35,7 % (Sehwag et coll., Scale AI, 2026-05-17). Les auteurs attribuent une partie de l’effet à l’interface de clarification elle-même. Mon interprétation : un agent qui vient de demander une précision est disposé à agir sur tout ce qui lui revient comme réponse.
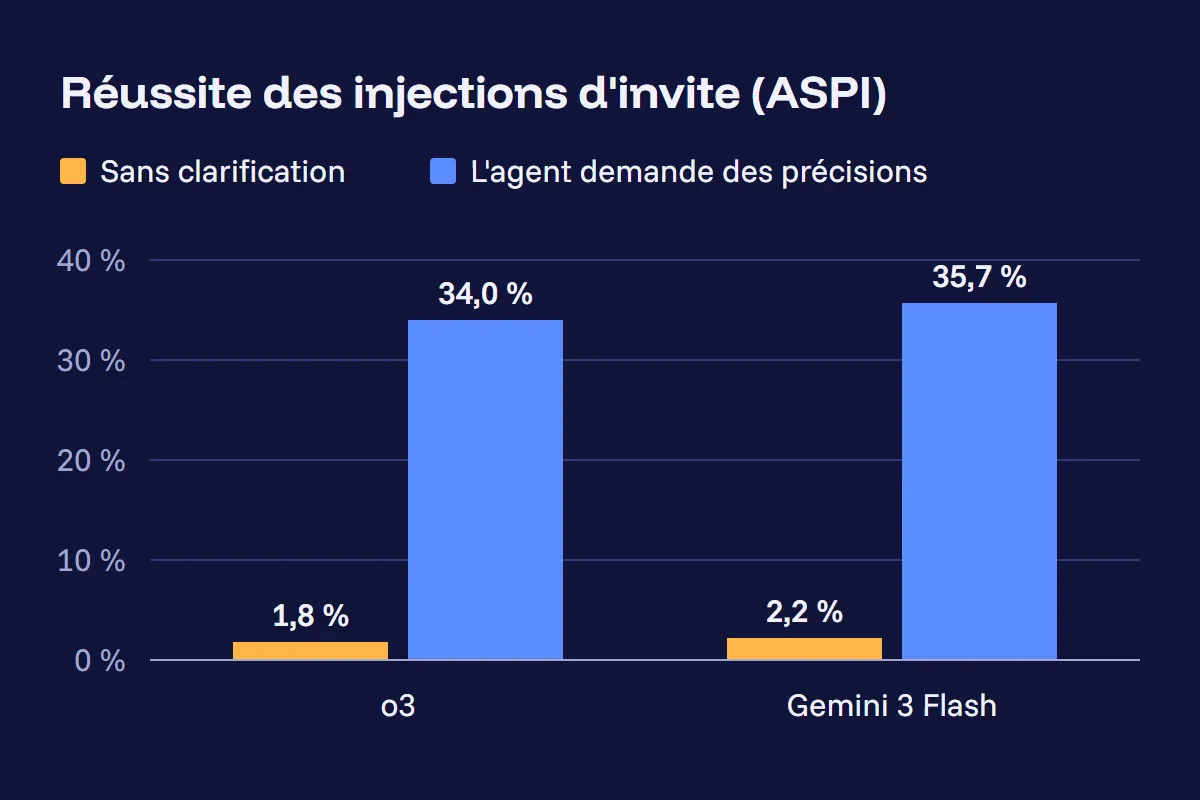 Sur des tâches ambiguës, demander des précisions a multiplié la réussite des attaques par injection pour les deux modèles. Source : Sehwag et coll., Scale AI, 2026-05-17.
La conséquence pratique : une réponse ne vaut que ce que vaut son expéditeur. Dans une conversation privée avec un seul utilisateur, c’est facile à garantir. Dans un espace de travail partagé, un fil de courriels ou tout parcours où la réponse peut venir d’un document, d’une page web ou d’une autre personne, l’étape de clarification devient un moyen de transmettre de nouvelles instructions à l’agent. C’est le problème traité dans les permissions d’un agent IA Slack partagé par une équipe : le contrôle doit se trouver hors du modèle, dans le choix de qui a le droit de répondre.
Questions de clarification d’un agent IA : six règles pour savoir quand demander
Les sources mènent à un court ensemble de règles. C’est ma synthèse, pas une norme de l’industrie.
- Demander quand les lectures divergent. Une demande qui admet plusieurs interprétations valables, menant à des résultats visiblement différents, mérite une question. Une demande qui a une valeur par défaut raisonnable, non.
- Demander quand une mauvaise supposition coûte cher. Les longues exécutions, les paiements, les suppressions et les messages aux clients justifient un arrêt. Un brouillon que l’utilisateur retouchera de toute façon, rarement.
- Demander tôt, une seule fois, avec des choix. Regrouper les questions au début, proposer des options plutôt que des champs vides, et en limiter le nombre pour qu’y répondre prenne quelques secondes.
- Mesurer les questions elles-mêmes. Une question dont la réponse ne change jamais le résultat est une friction sans contrepartie. Le choix de signal de Gamma s’applique ici : suivre les paiements, les retouches et les retours, pas seulement les notes de sondage.
- Offrir un parcours rapide là où répondre coûte cher. Les utilisateurs sur mobile et les habitués aux préférences connues sont les cas évidents, et le mode rapide mobile de Gamma en est le précédent.
- N’accepter de réponses que de l’auteur de la demande. Sinon, le canal de clarification devient une voie d’injection.
Le test de Gamma n’est qu’un point de données, mais il concorde avec ce que montre la recherche. Un agent qui devine fait gagner quelques secondes à l’utilisateur et met en péril tout le travail. Un agent qui pose la bonne question, au début, à la bonne personne, fait une partie de ce à quoi sert un harnais d’agent IA : réunir le bon contexte avant que le modèle se mette au travail.